Next: ZCA Up: Analisi ad autovalori Previous: Analisi ad autovalori
La Principal Component Analysis, o trasformazione discreta di Karhunen-Loeve KLT, è una tecnica che ha due importanti applicazioni nell'analisi dei dati:
Allo stesso modo esistono due formulazioni della definizione di PCA:
Un esempio pratico di riduzione delle dimensioni di un problema è l'equazione di un iperpiano in  dimensioni: esiste una base dello spazio che trasforma l'equazione del piano riducendola a
 dimensioni senza perdere informazione, facendo risparmiare così una dimensione al problema.
sere memorizzati nelle righe2.2 della matrice  di dimensioni
 , matrice pertanto che memorizza
 vettori aleatori di dimensionalità e con
 .
Ogni riga corrisponde a una diversa osservazione  e la distribuzione di questi esperimenti deve avere media, quantomeno quella empirica, nulla.
Assumendo che i punti abbiano media zero (cosa che si può sempre ottenere con la semplice sottrazione del centroide), la matrice di covarianza delle osservazioni è data da
 |
(2.69) |
Se i dati in ingresso  sono correlati, la matrice di covarianza
 non è una matrice diagonale.
L'obiettivo di PCA è trovare una trasformazione  ottima che trasformi i dati da correlati a decorrelati
 |
(2.70) |
ed ordinati in base al loro contenuto informativo in maniera tale che, se preso un sottoinsieme delle basi, possa tale approccio ridurre la dimensione del problema.
Se esiste una base ortonormale tale che la matrice di covarianza
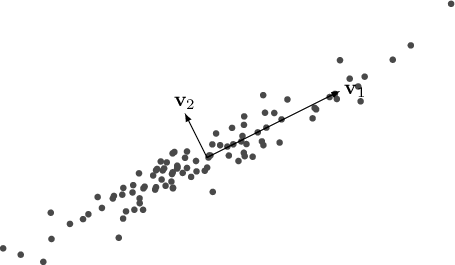
espressa in questa base sia diagonale, allora gli assi di questa nuova base si chiamano componenti principali di
(o della distribuzione di ).
Quando si ottiene una matrice di covarianza dove tutti gli elementi sono nulli tranne quelli sulla diagonale, significa che sotto questa nuova base gli eventi sono tra loro scorrelati.
Questa trasformazione può essere trovata risolvendo un problema agli autovalori: si può infatti dimostrare che gli elementi della matrice diagonale sono gli autovalori di
e che le varianze delle proiezioni del vettore sulle componenti principali coincidono con tali autovalori:
dove è la matrice degli autovettori (matrice ortogonale tale che
 ) e
 è la matrice diagonale degli autovalori ordinati
 .
Per ottenere questo risultato esistono due approcci.
Siccome
è una matrice simmetrica reale semidefinita positiva, può essere scomposta come
chiamata decomposizione spettrale, con matrice ortonormale degli autovettori e
matrice diagonale degli autovalori. Siccome la matrice
è semidefinita positiva, tutti gli autovalori sono non negativi.
Tale tecnica tuttavia richiede il calcolo esplicito di
.
Data una matrice rettangolare , la decomposizione ai valori singolari (SVD) permette di ottenere in modo numericamente stabile gli autovettori di
 e, attraverso il quadrato dei valori singolari, i corrispondenti autovalori.
La SVD costituisce pertanto la tecnica di riferimento per il calcolo delle componenti principali.
Attraverso la SVD è possibile decomporre la matrice degli eventi come

usando la rappresentazione Economy/Compact SVD, dove  contiene i vettori singolari sinistri (left singular vectors),
 contiene i valori singolari di e contiene i vettori singolari destri.
È da notare che usando la SVD non è necessario calcolare esplicitamente la matrice di covarianza
. Tale matrice può essere ricavata in un secondo momento attraverso
 |
(2.73) |
Confrontando questa relazione con l'equazione (2.72) si ottiene
 |
(2.74) |
Vanno ricordate le proprietà degli autovalori e dei valori singolari:
 e
condividono gli stessi autovalori non nulli.
 della matrice sono le radici quadrate degli autovalori di
:

Va inoltre ricordata una importante proprietà della SVD:
che rappresenta la migliore approssimazione di rango  della matrice nel senso della norma di Frobenius.
Questo fatto, unito alla caratteristica della SVD di restituire i valori singolari ordinati dal maggiore al minore, permette di approssimare una matrice con una di rango inferiore.
Selezionando gli autovettori associati agli autovalori maggiori è possibile costruire una matrice

le cui colonne formano una base ortonormale dello spazio ridotto. La proiezione di un vettore

su tale sottospazio è

con

Il vettore  rappresenta una descrizione a dimensionalitÃ
ridotta dei dati che preserva la maggior parte della varianza presente
nel sistema.
invece che a e viceversa.